인간 게놈 지도 작성 사업(Human Genome Project)이 종료된 지도 어언 20여 년의 세월이 지났다. 당시 약 30억 달러(한화 약 4조 원)라는 막대한 규모의 연구비가 13년 동안 투입되었으며, 이를 통해 하나의 인간 유전체 지도가 완성되었다. 이렇게 완성된 인간 유전체 지도는 말 그대로 인류의 자산이 되었다. 환자 집단 분석을 필두로 후속 유전체 연구가 대규모로 수행되었고, 이는 인구 집단과 질환에 대한 이해를 가져다주었다. 유전 변이 수준에서 인류를 이해할 수 있는 기반이 마련된 것이다.
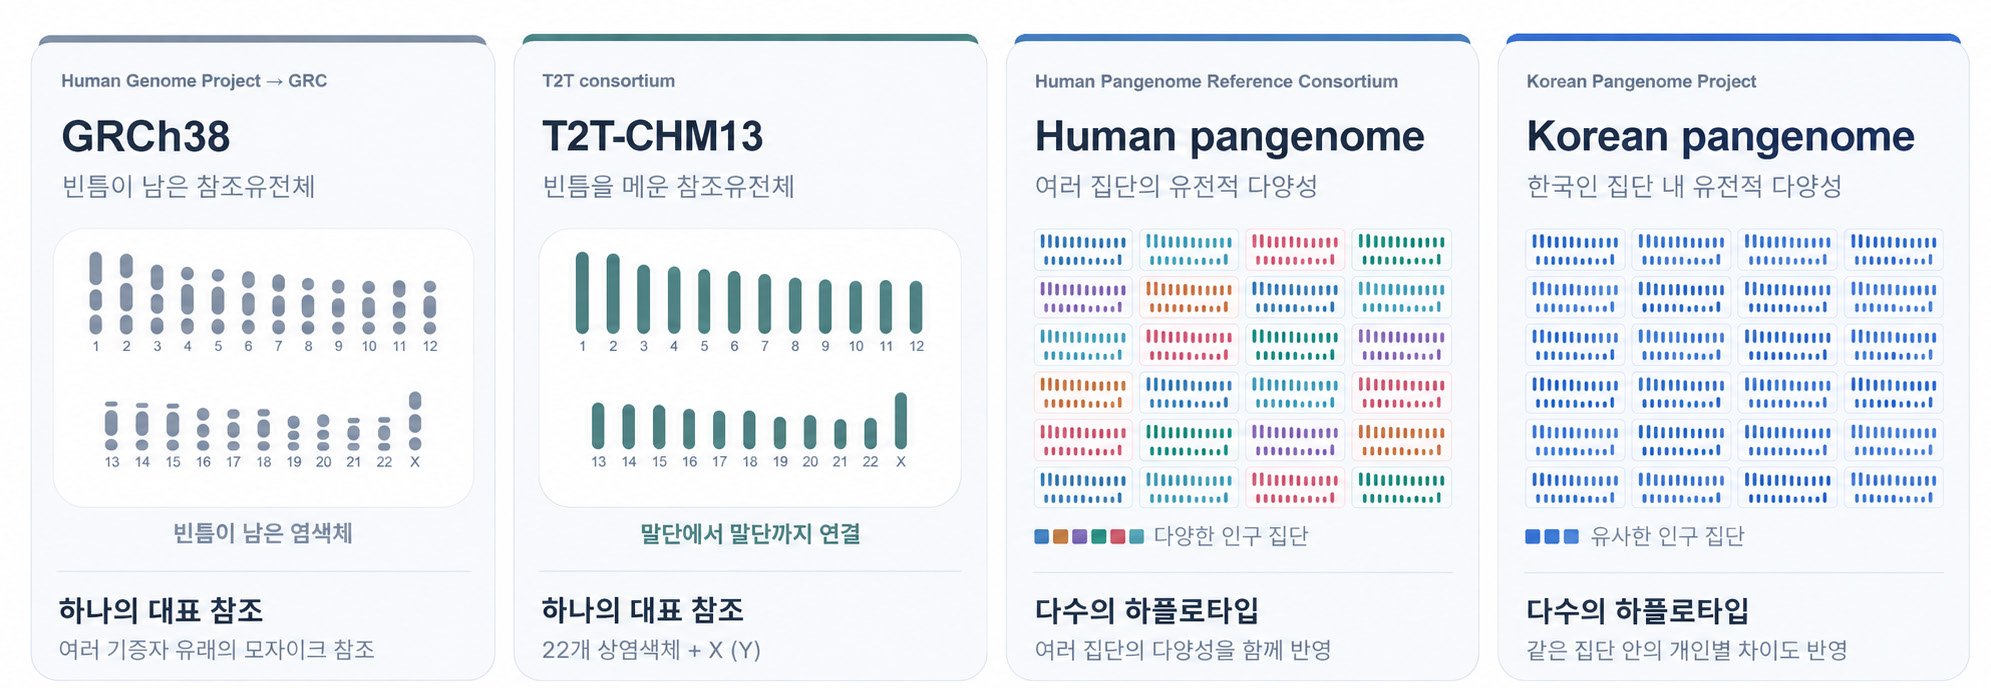
이렇게 확보된 인간 유전체 지도는 핵심적인 인프라로 자리 잡게 되었으나, 기술적인 한계로 인해 여전히 여러 문제를 내재하고 있었다. 가장 대표적인 문제 중 하나는 정확한 서열을 알지 못하는 염색체 지역이 약 1억 2천만 염기쌍 정도 남아있었다는 것이다. 특히 염색체 말단 인근에 해당하는 서브텔로미어(subtelomere) 지역, DNA 복제 과정에서 염색체가 방추사와 연결되는 센트로미어(centromere) 지역 등은 해당 영역의 특성상 반복서열이 밀집되어있어 서열이 명확하게 해독되지 못했다. 이외에도 유전자 내 또는 유전자 인근에 반복서열이 몰려있는 경우에도 문제가 발생하곤 했다. 기존에 널리 쓰이던 숏리드 시퀀싱(short-read sequencing) 기법은 한 번에 해독할 수 있는 리드의 길이가 수백 염기쌍 수준으로 짧아 반복서열은 물론이거니와 크기가 큰 구조 변이(Structural variant) 또한 잘 다루지 못한다는 것도 문제였다. 이처럼 해독이 어려운 암흑유전체(Genomic dark matter) 영역은 유전체 기반 진단의 한계점으로 생각되기도 했다.
이러한 암흑유전체 영역은 최근 롱리드(long-read) 시퀀싱 기법이 부상함에 따라 빠르게 해독되고 있다. 롱리드 시퀀싱은 기존 시퀀싱 기법에 비해 100~1000배 가까이 긴 리드를 제공해, 한 번에 수만 염기쌍 수준은 거뜬하게 읽어낼 수 있다는 장점을 지닌다. 가장 대표적인 사례는 인간 유전체 지도를 최초로 빈틈 하나 없이 메우는 데 성공한 사례이다(Nurk et al., 2022). 해당 연구는 서로 독립적인 롱리드 시퀀싱 플랫폼을 통합하여 기존 참조 유전체 지도에 남아있던 미지의 1억 2천만 염기쌍의 서열을 온전히 해독해내는 데 성공했다. 인간의 서브텔로미어와 센트로미어 서열이 최초로 완전히 해독된 셈이다. 그러나 이처럼 완전한 인간 유전체 지도에도 한계는 남아있었다. 이 또한 단 1개의 유전체 지도만 완성한 것이기에, 인구 집단에 존재하는 유전체 내 변이에 대한 전반적인 내용을 제공할 순 없었기 때문이다.
이러한 인구 집단 내 변이 연구는 현재 인간 범유전체 참조 컨소시엄(Human Pangenome Reference Consortium)을 중심으로 빠르게 진척되고 있다. 해당 컨소시엄은 인류 전체 집단에 존재하는 변이를 검출하여 참조 유전체 지도에 포괄하는 것을 목표로 한다. 이를 위해 다양한 계통(Ancestry)을 반영하는 350명 유래 세포주를 대상으로 모계 및 부계 유전체 지도를 분리하여 고품질 유전체 지도 700개를 확보하는 작업을 진행 중이다(Wang et al., 2022). 이를 통해 아시아, 유럽, 아프리카 등 다양한 인구 집단에 존재하는 변이를 그 종류 및 크기와 관계없이 검출하는 것이 가능해질 것으로 기대하며, 진정 인류를 대변할 수 있는 참조 유전체 지도로 나아가는 기반이 될 것으로 기대한다. 다만 이러한 사업은 그 특성상 특정한 인구 집단에 대한 깊이 있는 자료를 제공하지 못한다는 한계를 지니고 있다.
한국인 판지놈 프로젝트(Korean Pangenome Project)는 한국인이라는 특정 인구 집단에 대한 깊이 있는 변이 정보를 제공함으로써, 집단을 대변할 수 있는 참조 데이터셋을 구축하는 것을 목표로 이 문제를 해결하고자 한다. 구체적으로는 암, 희귀질환, 선천성 질환 등 건강 이상이 없으며, 채혈 당시 만 25세 이상 만 60세 이하에 해당하는 한국인 1,000명을 대상으로 한다. 채집하는 시료는 혈액이며, 혈액 중 일부는 불멸화 세포 생산에 쓰여 세포주로 보관된다. 현재 목표로는 크게 롱리드 DNA 시퀀싱 데이터, 롱리드 RNA 시퀀싱 데이터, 일부 단백체 데이터를 생산하는 것을 목표로 하고 있다. 달리 말하면 개개인의 맞춤형 고품질 유전체 지도 2,000개와 스플라이싱(Splicing) 해독이 가능한 전사체 데이터, 그리고 단백질 수준의 연계까지 가능케 할 단백체 데이터가 모두 함께 확보되는 셈이다.
확보된 데이터는 모두 한국인의 표준으로 활용될 수 있으리라 기대한다. 한국 집단 내 빈도 0.05% 수준의 변이는 대부분 검출될 것으로 기대하며, 여전히 부족하긴 하지만, 희귀질환 원인 변이 검출을 위한 중요한 대조군이 될 것으로 보인다. 또한 알려진 원인 변이를 쉽게 검출하는 것을 넘어, 다양한 변이의 기능을 밝히는 것도 가능할 것으로 보인다. 특히 개인에게서 검출된 변이를 전사체 및 단백체 데이터와 통합함으로써 인구 집단에 존재하는 변이가 유전자 발현, 스플라이싱, 단백질 서열 변화 등에 어떻게 기여할 수 있는지 확인할 수 있을 것이다. 이렇게 구축된 유전체, 전사체, 단백체 참조 데이터는 환자에서 확인된 수많은 변이 중 어떤 것이 실제 기능 변화를 유도할 수 있을지 이해하는 기반이 될 것으로 기대한다.
이처럼 유전체 기반 기술은 빠르게 발전하며 인류를 이해하고 해석하기 위한 단단한 토대를 다지고 있다. 변이를 검출하고 기능을 확인할 수 있다는 측면에서 이러한 롱리드 시퀀싱 기반의 방법론과 한국인 판지놈 프로젝트의 연구 데이터는 미래 유전체 기반 진단의 핵심이 될 수 있을 것으로 기대한다. 향후 한국인 판지놈 프로젝트에서 공개할 통합적인 데이터가 국내외에서 적극 활용됨으로써 유전체 진단 기술이 보다 빠르게 발전하게 되길, 환자와 사회에 기여할 수 있게 되길 바란다.
References
- Nurk, Sergey, et al. "The complete sequence of a human genome." Science 376.6588 (2022): 44-53.
- Wang, Ting, et al. "The Human Pangenome Project: a global resource to map genomic diversity." Nature 604.7906 (2022): 437-446.