ChatGPT를 비롯한 생성형 인공지능이 빠르게 발전하면서 의료 분야에서도 AI를 활용한 정보 검색과 의사결정 지원이 점차 익숙한 모습이 되고 있다. 동시에 의료 지식과 전문 데이터에 특화된 AI 서비스도 속속 등장하고 있다. 그렇다면 의료에 특화된 AI는 범용 AI보다 실제로 더 뛰어난 성능을 보일까? 최근 Nature Medicine에 발표된 Vishwanath 등[1]의 연구는 이 질문을 정면으로 다루었다.
우리는 일반적으로 의학적 궁금증이 생기면 PubMed나 Google Scholar에서 관련 논문을 검색하거나, UpToDate와 같은 의학정보 서비스에서 필요한 내용을 직접 찾아 읽는 방식으로 진행해왔다. 반면 최근의 생성형 AI 기반 서비스는 의사가 자연어로 질문하면 관련 논문이나 진료지침을 찾아 내용을 정리하고, 근거와 함께 하나의 답변으로 제시해준다. 의료 특화 LLM 중 OpenEvidence, UpToDate Expert AI, ClinicalKey AI, Dyna AI Mode, AMBOSS AI Mode 등이 대표적인 예다. 이들 서비스의 세부 구조는 서로 다르고 일부는 내부 아키텍처를 공개하지 않지만, 전문 의료 콘텐츠를 검색하여 생성형 AI의 답변에 연결한다는 공통된 방향을 가지고 있다[1,2].
이러한 시스템을 이해하는 데 자주 등장하는 개념이 검색증강생성(Retrieval-Augmented Generation, RAG)이다. 전형적인 RAG에서는 외부 문서를 검색 가능한 형태로 색인한 뒤, 질문과 관련성이 높은 문서나 문서 조각을 찾아 LLM의 입력 context에 추가하고 이를 바탕으로 답변을 생성한다[2,3]. Dense retrieval에서는 문서와 질문을 embedding vector로 표현하여 의미적 유사성을 이용할 수 있고, 실제 시스템에서는 lexical search나 hybrid search, reranking 등 여러 기법이 함께 사용될 수 있다[2].
RAG의 장점은 모델이 자체 기억에만 의존하지 않고 최신 문헌이나 검증된 전문 자료를 답변에 연결하므로 환각을 줄일 수 있다는 것이다. 일반적으로 RAG는 Top-k 방식으로 관련성 높은 자료를 k개 만큼 짜집기 하는 방식으로 이루어진다. 모으는 문서 수가 많으면 그 문서 안에 가장 중요한 단서를 가진 자료가 있을 확률이 증가하지만, 너무 커지면 처리할 텍스트 양이 증가하고, 처리 속도 저하 등이 발생할 수 있다. 또한 그 문서의 위치, 주변의 방해 정보에 따라서도 그 성능이 저하될 수 있다[2,4]. 따라서 RAG의 실제 성능은 retrieval의 정확성, 문서 순위, context 선택, 그리고 기반 LLM이 검색된 근거를 얼마나 잘 해석하고 종합하는지에 함께 좌우된다. 의료 특화 LLM 제품들도 일반적으로 환각률을 낮추고 인프라 비용을 줄일 수 있어, RAG를 사용할 것으로 추정된다.
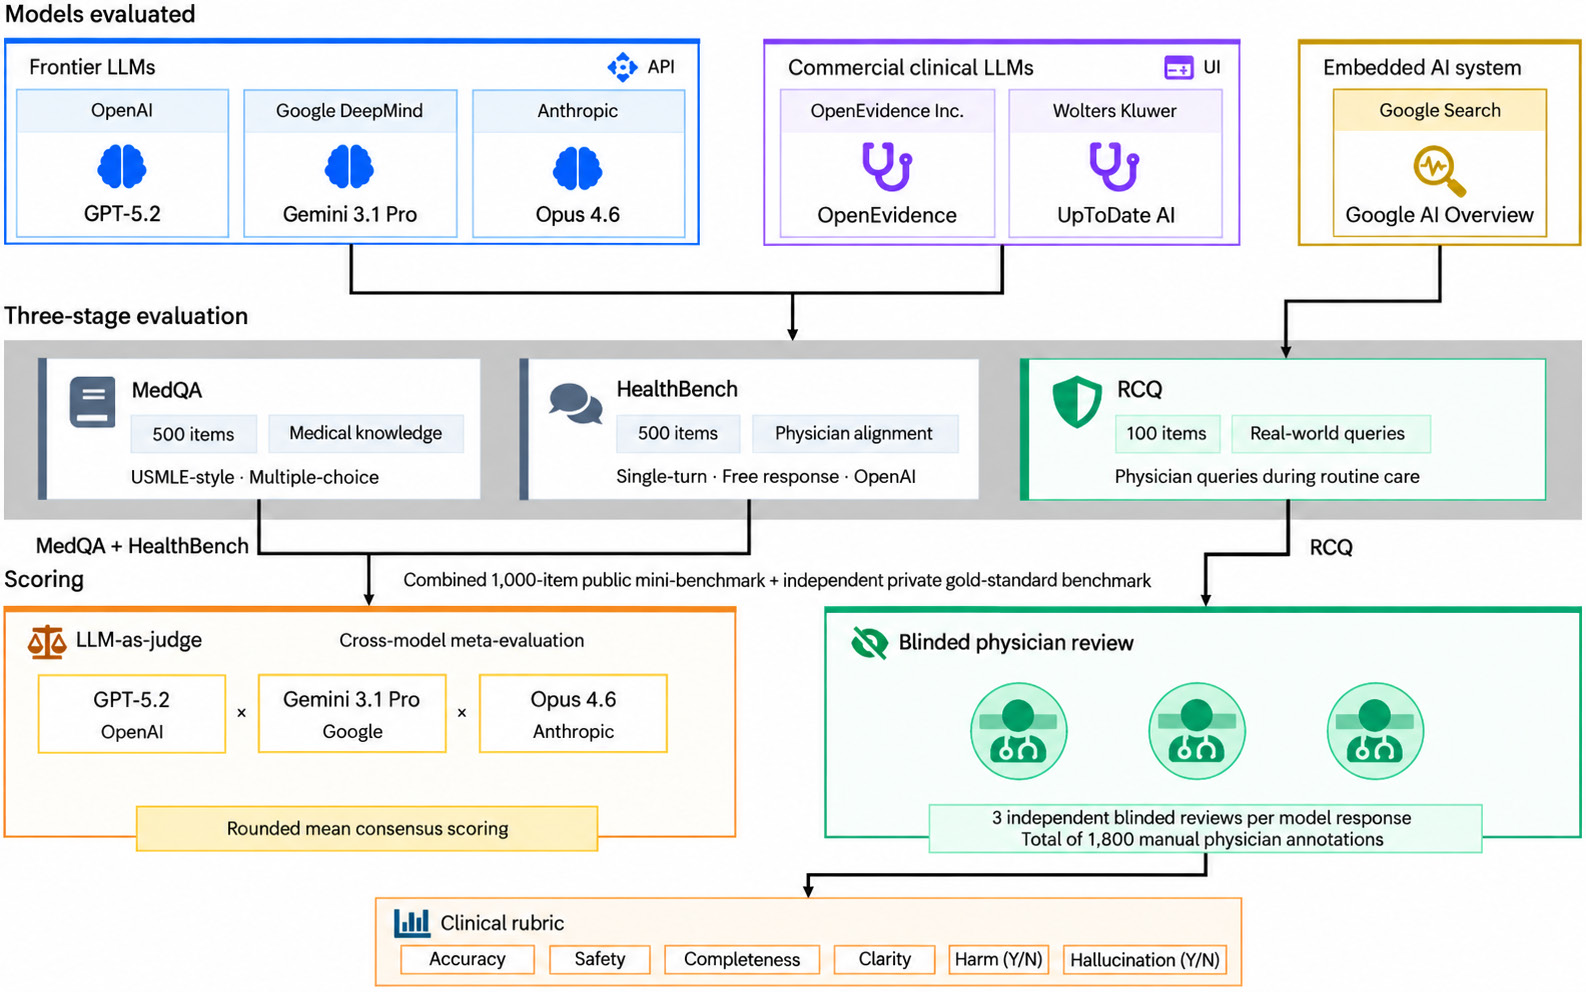
이번 Nature Medicine 연구의 연구진은 의료 특화 AI인 OpenEvidence와 UpToDate Expert AI를 범용 frontier LLM인 GPT-5.2, Gemini 3.1 Pro, Claude Opus 4.6과 직접 비교하였다. 평가는 3개의 벤치마크 세트로 구성되었다. USMLE 형식의 의학 지식을 평가하는 MedQA 500문항과 의료 답변의 정확성과 완전성, 의사소통 등을 평가하는 HealthBench 500문항, 그리고 실제 임상 환경에서 의료진이 입력한 질문 100개로 구성된 Real Clinical Queries (RCQ) benchmark가 그것이다. RCQ에서는 미국 임상의 12명이 모델의 정체를 모르는 상태에서 답변을 평가했고, 각 질문-모델 답변은 세 명의 평가자가 임상적 정확성, 완전성, 안전성, 명료성의 네 영역을 평가하였다.
의료 특화 AI니까 의료 질문에 더 잘 대답하는게 당연할 것이라 생각할 수 있겠지만, 결과는 예상과 달랐다.
MedQA에서 Gemini 3.1 Pro의 정확도는 97.4%로 가장 높았고, GPT-5.2 94.2%, Claude Opus 4.6 90.2%가 뒤를 이었다. OpenEvidence와 UpToDate Expert AI는 각각 89.6%, 88.4%였다.
HealthBench에서도 GPT-5.2가 88.0점으로 가장 높았고 Gemini 79.3점, Claude 77.0점에 이어 OpenEvidence 62.6점, UpToDate Expert AI 61.3점 순이었다. 더 중요한 결과는 실제 임상 질문을 사용한 RCQ에서 나타났다. 평균 종합점수는 Gemini 3.1 Pro 3.62점, GPT-5.2 3.54점, Claude Opus 4.6 3.52점으로 세 범용 frontier LLM이 성능이 더 우수한 것으로 나타났다. 반면 OpenEvidence 3.24점, UpToDate Expert AI 3.17점, Google AI Overview 3.27점으로 유의미하게 낮았다. 저자들은 frontier 모델의 우위가 단순한 평균값 차이에 그치지 않고 많은 개별 질문에서도 나타났다고 보고하였다.
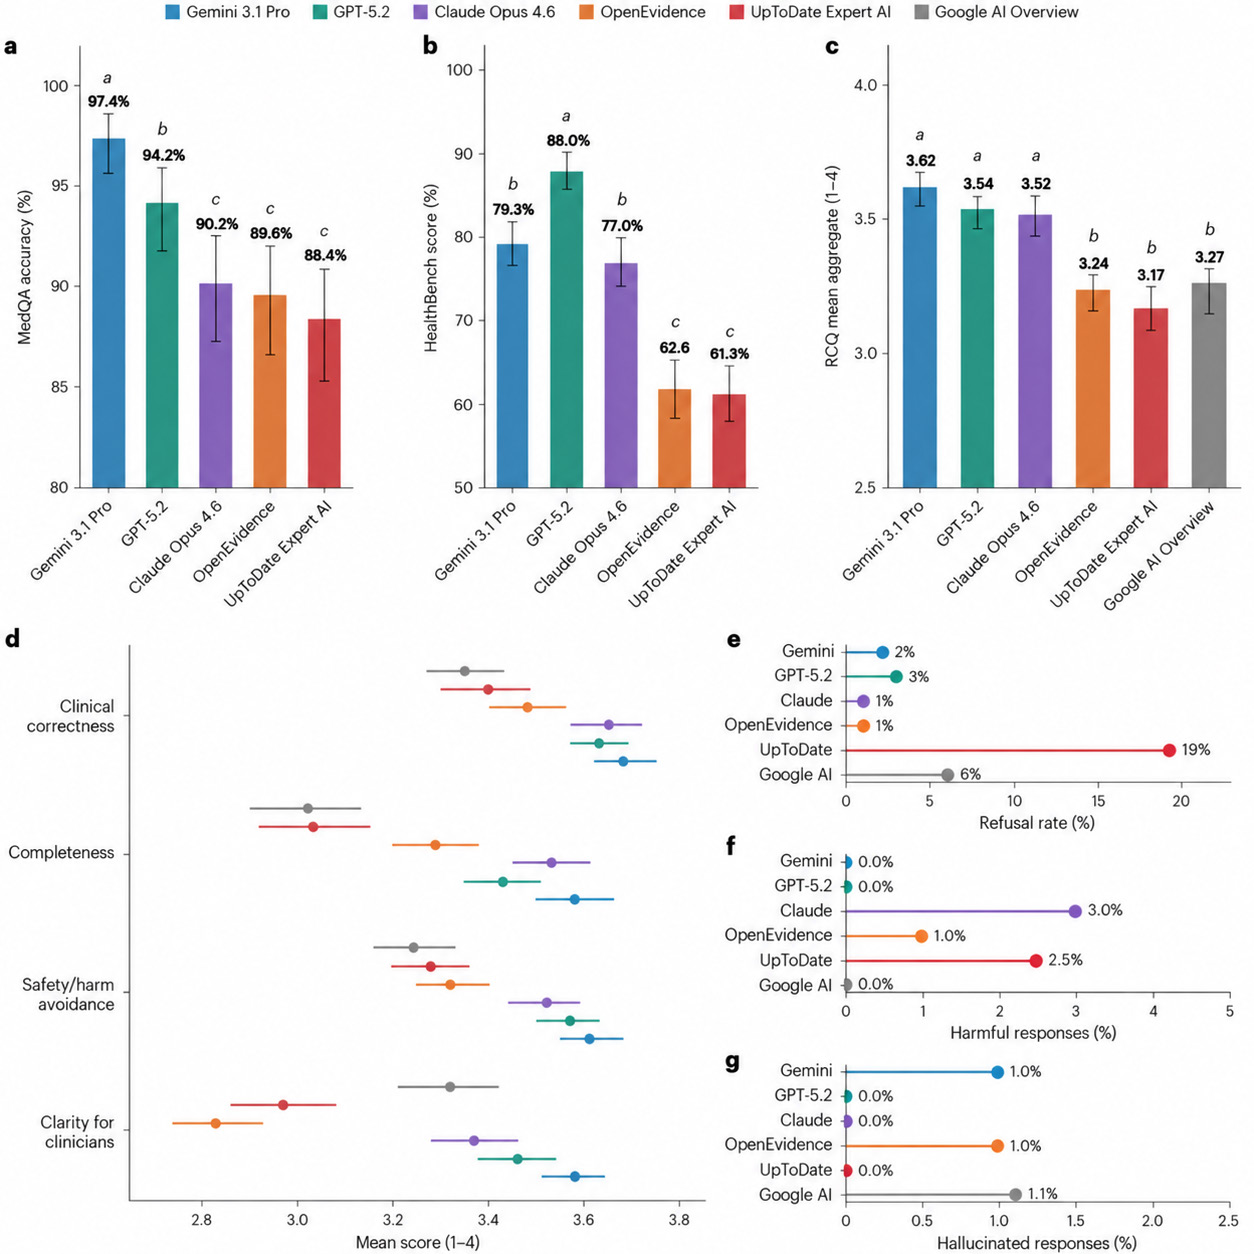
RCQ의 세부 결과도 흥미롭다. 모델 간 차이는 임상적 정확성보다 명료성 점수에서 더 크게 나타났고, OpenEvidence는 특히 명료성 점수가 낮았다. 낮은 점수의 답변을 질적으로 검토했을 때 불완전한 임상 내용, 안전에 중요한 정보의 누락, 정돈되지 않은 설명 등이 반복적으로 관찰되었다. UpToDate Expert AI는 RCQ 질문의 19%에 답변을 거부한 반면 다른 주요 모델의 거부율은 대체로 1–3% 수준이었다. 반면 유해한 내용이나 환각 발생률에서는 모델 간 유의한 차이가 없었다. 이번 벤치마크 연구에서는 정확성뿐 아니라 완전성, 명료성, 실제 사용성이 함께 평가되었으며 frontier LLM의 외부 검색이 허용되어 있다.
이번 연구는 여러모로 충격적인 결과로 다가온다. 이미 많은 벤쳐 기업이 설립됐고 많은 자본이 투자된 의료 특화 AI 언어 모델의 장점이 생각보다 크지 않다는 근거 자료가 되기 때문이다. 환각을 줄이고 보수적인 설계를 했지만, 거대 자본 AI 회사의 다목적 제품이 더 우수할 수 있다는 결론으로 이어진다.
이 연구에는 중요한 한계도 있다. 비교적 최근 논문이지만, 최근의 눈부신 프론티어 AI 모델의 배포 속도와 비교하면 일부 현실과 맞지 않는다. 이 연구 결과에서는 프론티어 모델 간 비교에서 제미나이가 가장 우수한 모델처럼 보이지만, 출판된지 몇달이 지난 지금은 이 순위는 이미 완전히 뒤집힌 상태다.
벤치마크 방식에 있어서도 비판을 받는 상태다. Beaulieu-Jones와 Nemati는 2026년 9월 Nature Medicine의 Matters Arising에서 공개 벤치마크의 contamination, HealthBench의 잠재적 편향, 그리고 RCQ의 규모와 일반화 가능성 등을 근거로 연구 결론의 범위를 제한해야 한다고 주장하였다[5]. 즉 모델이 이미 학습한 데이터를 기반으로 테스트했을 가능성이 있다고 비판을 받았다. 이에 대해 원 연구진은 공개 벤치마크 데이터 사용으로 인한 한계를 인정하면서도 이를 보조적 근거로 보고 있으며, 실제 의료진이 맹검 평가한 RCQ는 사전에 유출되지 않았으므로, 이 조건하에서는 범용 frontier LLM이 의료 특화 AI보다 우수했다는 핵심 결론을 유지하였다[6].
그렇다면 이번 연구 결과는 최신 frontier LLM을 의료 현장에서 그대로 신뢰해도 된다는 뜻일까? 그렇지는 않다. 이번 연구가 보여준 것은 세 범용 LLM이 비교 대상이 된 두 의료 특화 AI보다 상대적으로 높은 성능을 보였다는 것이지, 개별 환자 수준에서 오류 가능성이 충분히 제거되었다는 의미는 아니다. Omar 등[7]은 20개 LLM에 340만 건이 넘는 오류 정보가 프롬프트에 포함된 대규모 의료 데이터 연구에서 약 32%의 경우에서 LLM이 허위 정보를 그대로 받아들인다고 보고한 바 있다.
이러한 점은 진단유전학에서 특히 중요하다. 생성형 AI는 유전변이의 임상적 의미를 조사하고, 관련 논문과 가이드라인을 검색하며, 검사 결과를 설명하거나 보고서 작성을 보조하는 데 상당한 잠재력이 있다. 그러나 실제 판독에서는 정확한 변이 표기, 질환-유전자 관계, 근거의 최신성, 분류기준의 세부 조건, 검사법의 한계와 같은 작은 차이가 최종 해석을 바꿀 수 있다. 따라서 진단유전학에서 AI를 활용할 때는 결과의 그럴듯함보다 근거의 출처와 최신성, 중요한 조건의 누락 여부를 확인하는 과정이 특히 중요하다.
References
- Vishwanath K, Alyakin A, Ghosh M, et al. General-purpose large language models outperform specialized clinical AI tools on medical benchmarks. Nat Med. 2026;32:2405–2409. doi:10.1038/s41591-026-04431-5 (https://doi.org/10.1038/s41591-026-04431-5)
- Amugongo LM, Mascheroni P, Brooks S, Doering S, Seidel J. Retrieval augmented generation for large language models in healthcare: a systematic review. PLOS Digit Health. 2025;4(6):e0000877. doi:10.1371/journal.pdig.0000877 (https://doi.org/10.1371/journal.pdig.0000877)
- Lewis P, Perez E, Piktus A, et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Adv Neural Inf Process Syst. 2020;33:9459–9474.
- Liu NF, Lin K, Hewitt J, et al. Lost in the Middle: How Language Models Use Long Contexts. Trans Assoc Comput Linguist. 2024;12:157–173. doi:10.1162/tacl_a_00638 (https://doi.org/10.1162/tacl_a_00638)
- Beaulieu-Jones B, Nemati S. Limited benchmarks constrain the conclusions of a general-purpose versus clinical AI comparison. Nat Med. 2026. doi:10.1038/s41591-026-04638-6 (https://doi.org/10.1038/s41591-026-04638-6)
- Vishwanath K, Aphinyanaphongs Y, Oermann EK. Reply to: Limited benchmarks constrain the conclusions of a general-purpose versus clinical AI comparison. Nat Med. 2026. doi:10.1038/s41591-026-04637-7 (https://doi.org/10.1038/s41591-026-04637-7)
- Omar M, Sorin V, Wieler LH, et al. Mapping the susceptibility of large language models to medical misinformation across clinical notes and social media: a cross-sectional benchmarking analysis. Lancet Digit Health. 2026;8(1):100949. doi:10.1016/j.landig.2025.100949 (https://doi.org/10.1016/j.landig.2025.100949)